作者: Damon Li
更新日期: 2026年1月6日
本文档旨在帮助学习者快速理解 GUI Agent 领域的关键概念、评测基准和技术术语。
AndroidWorld 是一个在真实 Android 模拟器上运行的动态评测环境,用于构建和评估自主计算机控制智能体。它包含 116 个跨越 20 个真实应用的手工设计任务,并通过动态参数实例化,可生成数百万种独特的任务变体。

核心特性:
| 特性 | 描述 |
|---|---|
| 任务多样性 | 116 个覆盖 20 个真实应用的任务 |
| 动态实例化 | 随机生成任务参数,避免模型"背答案" |
| 可靠的奖励信号 | 提供明确的任务成功与否判断 |
| 开放环境 | 可访问数百万 Android 应用和网站 |
| 轻量级 | 占用资源少(2GB 内存,8GB 磁盘) |
| 可扩展性 | 易于添加新任务和评测基准 |
来源: AndroidWorld: A Dynamic Benchmarking Environment for Autonomous Agents
OSWorld 是一个可扩展的、真实的计算机操作环境,用于评测多模态智能体在开放式任务中的表现。它支持在主流操作系统(Ubuntu, Windows, macOS)的虚拟机中执行 369 个真实世界的任务。
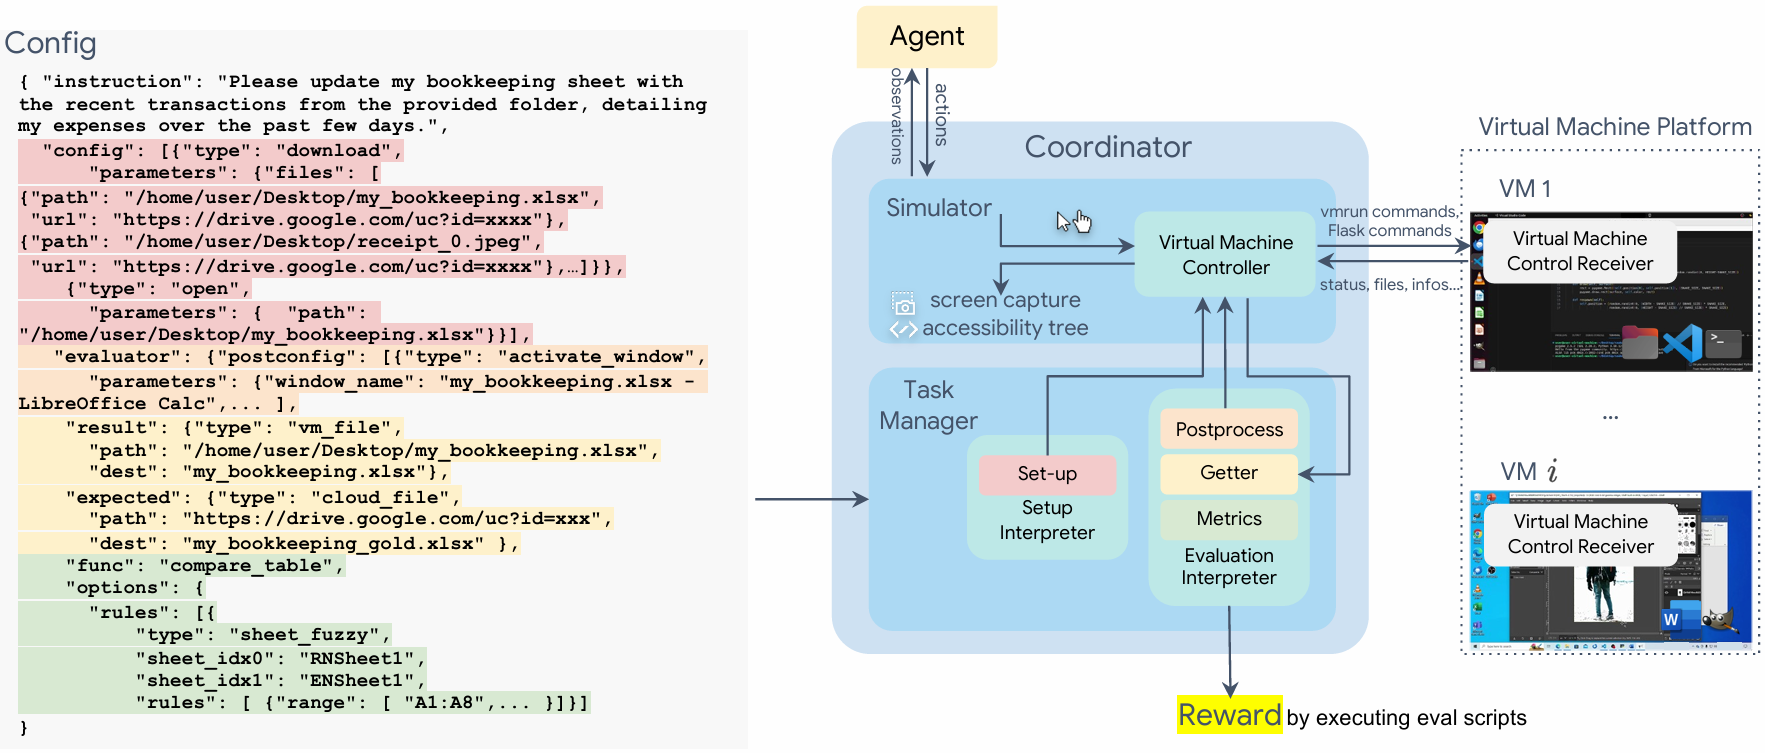
核心特性:
| 特性 | 描述 |
|---|---|
| 跨平台 | 支持 Ubuntu, Windows, macOS |
| 真实环境 | 在真实的虚拟机中执行任务,而非模拟环境 |
| 任务多样性 | 包含文件管理、网页浏览、多应用协作等 369 个真实世界任务 |
| 可扩展性 | 允许研究人员轻松添加新的任务和应用 |
来源: OSWorld: Benchmarking Multimodal Agents for Open-Ended Tasks in Real Computer Environments
ScreenSpot 和 ScreenSpot-Pro 是专注于评测 GUI 视觉定位 (Grounding) 能力的基准。它们要求模型根据自然语言指令,在复杂的、高分辨率的 GUI 截图中,准确地预测点击位置。
| 基准 | 描述 |
|---|---|
| ScreenSpot | 包含来自 iOS, Android, macOS, Windows 和 Web 的 1200+ 条指令 |
| ScreenSpot-Pro | 专注于专业、高分辨率的桌面 GUI,包含 1581 条指令,界面元素更小、更密集 |

来源: ScreenSpot-Pro: GUI Grounding for Professional High-Resolution Computer Use
MobileWorld 是一个用于评测移动端 GUI Agent 在复杂任务上的表现的基准。它包含需要跨应用协作、长程规划的复杂任务。
AndroidControl 是一个用于评测 Android 设备上 GUI Agent 控制能力的基准,包含高级和低级两种类型的任务。
| 任务类型 | 描述 |
|---|---|
| High-Level | 高级任务,需要多步操作完成 |
| Low-Level | 低级任务,单步操作即可完成 |
GUI Odyssey 是一个专注于跨应用导航任务的评测基准,测试 Agent 在多个应用之间切换并完成复杂任务的能力。
CAGUI (Chinese Android GUI) 是一个专注于中文 Android 应用的 GUI Agent 评测基准,由清华大学 THUNLP 和面壁智能联合构建。
核心特性:
- 覆盖 30+ 款热门中文 App
- 包含大规模双语(中英文)Android 数据集
- 专注于中文应用场景的适配和评测
指模型将自然语言指令与 GUI 界面上的具体视觉元素(如按钮、输入框、图标)准确关联起来的能力。这是 GUI Agent 执行操作的基础。
示例:
- 输入: "点击发送按钮"
- 输出:
click(850, 1200)(发送按钮的坐标)
定义了 Agent 可以执行的所有可能操作的集合。常见的动作包括:
| 动作 | 描述 | 示例 |
|---|---|---|
click(x, y) |
点击屏幕上的某个坐标 | click(500, 300) |
type(text) |
在当前聚焦的输入框中输入文本 | type("Hello World") |
scroll(direction) |
向特定方向滚动屏幕 | scroll(down) |
drag(x1, y1, x2, y2) |
从一个位置拖动到另一个位置 | drag(100, 200, 300, 400) |
long_press(x, y) |
长按屏幕上的某个坐标 | long_press(500, 300) |
back() |
返回上一页 | back() |
home() |
返回主屏幕 | home() |
定义了 Agent 在每个时间步可以感知到的环境信息。通常包括:
| 观察类型 | 描述 |
|---|---|
| 屏幕截图 | 当前界面的视觉信息(图像) |
| UI 元素树 | 界面的结构化信息,包含元素的类型、位置、文本等(XML/JSON) |
| 历史记录 | 之前执行的动作和观察的历史 |
将复杂任务分解给多个专门化的智能体协作完成的架构。常见的角色包括:
| 角色 | 职责 |
|---|---|
| Manager | 任务规划和分解 |
| Executor | 执行具体操作 |
| Reflector | 反思和错误纠正 |
| Notetaker | 记录关键信息 |
代表方案: Mobile-Agent-v3, MAI-UI
监督微调,使用"指令-动作"对的数据集来训练模型,让模型学会根据指令执行正确的操作。
数据格式:
输入: [屏幕截图] + "请点击设置按钮"
输出: click(750, 1100)
强化微调,在 SFT 的基础上,使用强化学习的方法,通过奖励信号(如任务是否成功)来进一步优化模型的决策能力。
奖励设计:
- 任务成功: +1
- 任务失败: 0
- 中间步骤: 根据进度给予部分奖励
在真实或模拟环境中,让 Agent 实时与环境交互,根据反馈不断优化策略。
代表方案: MAI-UI, AutoGLM
不需要针对特定任务进行训练,直接使用预训练的视觉语言模型来执行 GUI 操作。
代表方案: GELab-Zero
视觉语言模型,能够同时理解图像和文本的多模态模型,是构建 GUI Agent 的核心基础模型。
常见的基础 VLM:
| 模型 | 开发者 | 参数规模 |
|---|---|---|
| Qwen2-VL | 阿里通义 | 7B/72B |
| Qwen2.5-VL | 阿里通义 | 7B/72B |
| Qwen3-VL | 阿里通义 | 4B |
| MiniCPM-V | 面壁智能 | 8B |
| GLM-4V | 智谱 AI | 9B |
| Step-1.5V | 阶跃星辰 | 4B/8B |
混合专家模型,通过动态路由机制,只激活部分专家网络来处理输入,从而在保持大模型能力的同时降低计算成本。
代表方案: MAI-UI-235B-A22B (235B 总参数,22B 激活参数)
模型上下文协议,一种标准化的协议,用于定义 Agent 与外部工具、服务之间的交互方式。
代表方案: GELab-Zero (GUI-MCP)
Android 调试桥,用于与 Android 设备进行通信的命令行工具。GUI Agent 通常通过 ADB 来执行点击、滑动等操作。
常用命令:
adb shell input tap 500 300      # 点击坐标 (500, 300)
adb shell input swipe 100 500 100 100  # 从 (100, 500) 滑动到 (100, 100)
adb shell input text "Hello" # 输入文本任务完成的比例,是最直接的评测指标。
预测的点击位置与真实目标位置的匹配程度。
完成任务所需的平均步骤数,步骤越少越好。
- AndroidWorld: A Dynamic Benchmarking Environment for Autonomous Agents
- OSWorld: Benchmarking Multimodal Agents for Open-Ended Tasks in Real Computer Environments
- ScreenSpot-Pro: GUI Grounding for Professional High-Resolution Computer Use
- UI-TARS: Pioneering Automated GUI Interaction with Native Agents
- MAI-UI Technical Report
- AgentCPM-GUI Technical Report
- Mobile-Agent-v3 GitHub Repository